Article
Cache Google : 5 méthodes pour voir une page archivée en 2026
SEO12 min de lecture
James BrunettoCo-fondateur & CEO
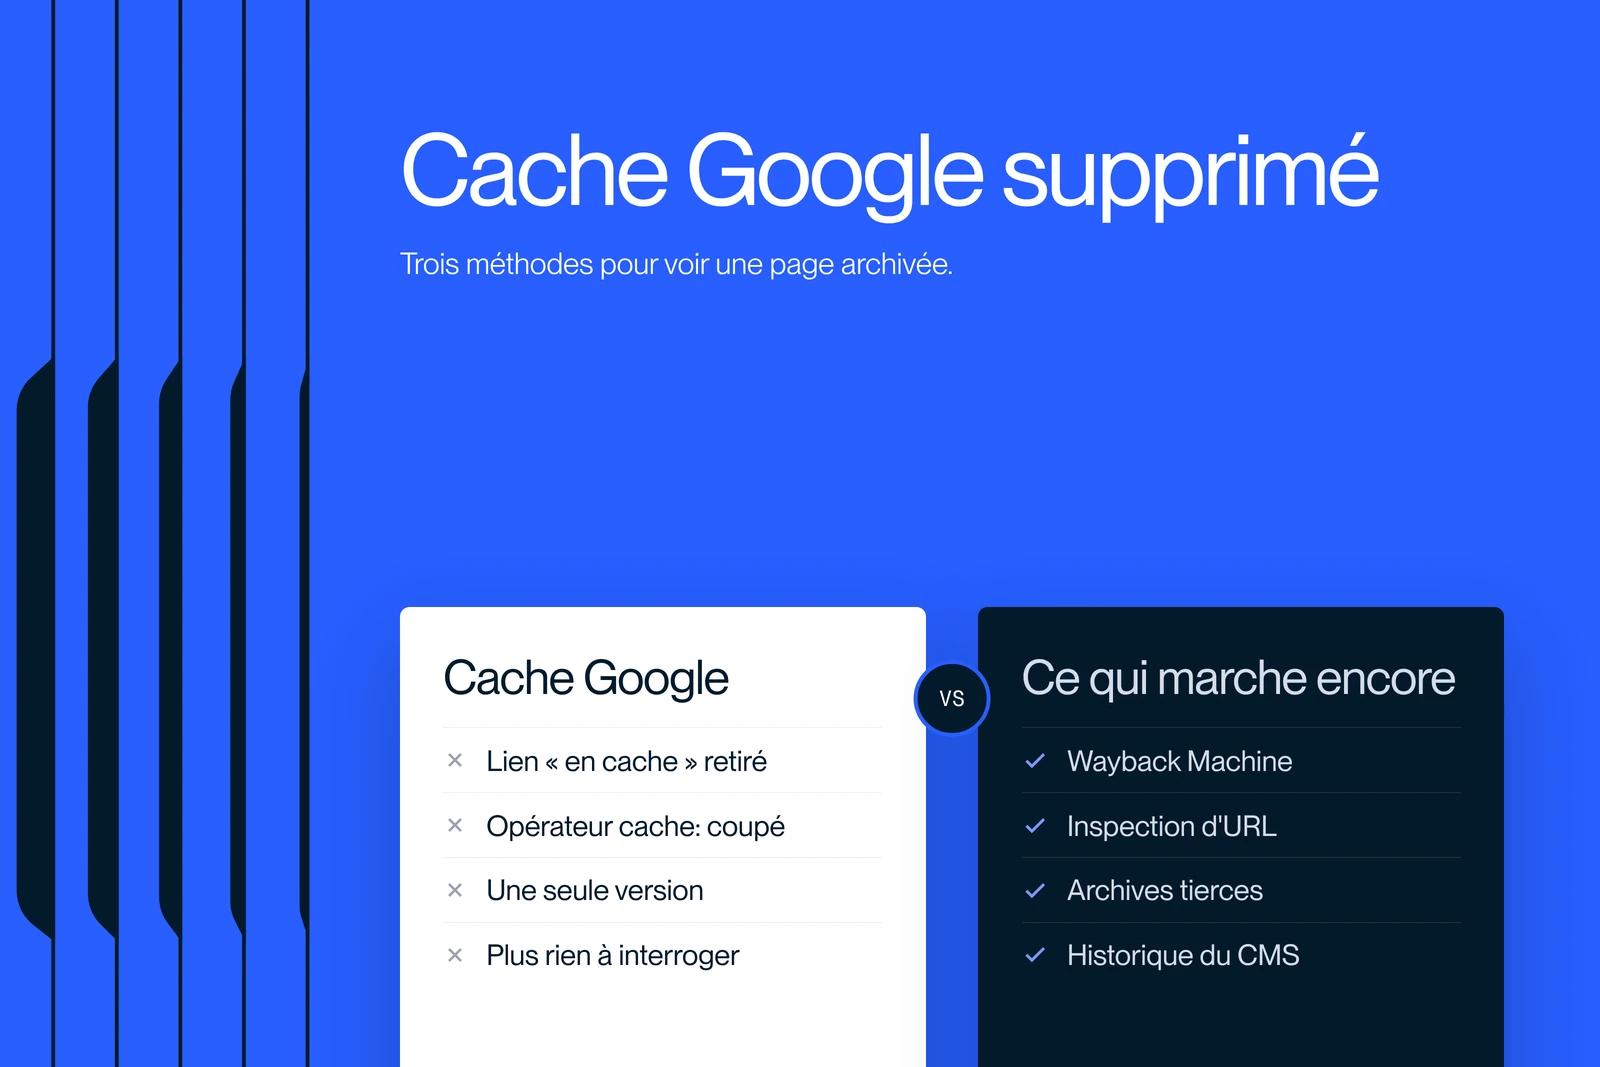
Le cache Google n'existe plus : le lien « En cache » a disparu des résultats fin janvier 2024 et l'opérateur cache: a été coupé le 24 septembre 2024. Pour voir une page archivée aujourd'hui, passez par la Wayback Machine, désormais liée depuis les résultats Google, ou par l'inspection d'URL de la Search Console pour votre propre site.
Cet article donne la méthode selon le besoin, ce que « vider le cache Google » veut vraiment dire, et la façon dont nous vérifions ce que Google voit pendant une migration.
Explorer cet article avec…
En bref : Google a retiré le lien « En cache » de ses résultats fin janvier 2024 (confirmation de Danny Sullivan le 1er février), ajouté un lien vers la Wayback Machine dans « À propos de ce résultat » le 11 septembre 2024, puis coupé l'opérateur cache: le 24 septembre 2024. Bing a suivi en décembre 2024. En 2026, trois outils remplacent le cache : la Wayback Machine pour n'importe quelle page, archive.today pour une capture à la demande, et l'inspection d'URL de la Search Console pour les pages que vous administrez. Il n'existe aucun bouton « vider le cache Google » : on demande une réindexation.
Ce que Google a retiré, et quand
Le cache Google était une copie de chaque page conservée par Google au moment de l'exploration, consultable depuis les résultats. Il a disparu en trois temps, puis Bing a fait de même.
| Date | Ce qui change | Source |
|---|---|---|
| Fin janvier 2024 | Le lien « En cache » sous les résultats disparaît. Danny Sullivan, porte-parole de Google Search, le confirme le 1er février 2024. | Post de Danny Sullivan sur X, relayé par 9to5Google |
| 11 septembre 2024 | Google ajoute un lien « Voir les versions précédentes sur la Wayback Machine » dans le panneau « À propos de ce résultat », en 40 langues. | Annonce d'Internet Archive |
| 24 septembre 2024 | L'opérateur cache: ne fonctionne plus et sa documentation est retirée. | Confirmation de Google, relayée par Search Engine Roundtable |
| 11 décembre 2024 | Bing retire à son tour ses liens de cache des résultats. | Annonce de l'équipe Bing Webmaster sur X |
Danny Sullivan a résumé la raison : la fonctionnalité datait d'une époque où le chargement d'une page n'était pas fiable, et la situation s'était nettement améliorée. Le cache coûtait de l'infrastructure pour un usage devenu marginal.
Le 24 septembre 2024, Google a confirmé que « l'opérateur cache: ne fonctionne plus dans la recherche Google ». Taper cache:votresite.fr renvoie désormais une recherche ordinaire sur ce mot.
Conséquence pour la balise noarchive : la documentation Google des balises robots la classe désormais parmi les règles historiques, ignorées par Google Search. Elle ne protège plus rien côté Google. Les autres services d'archivage, eux, peuvent continuer à la respecter.
Les cinq méthodes qui marchent en 2026
1. La Wayback Machine, pour n'importe quelle page
La Wayback Machine d'Internet Archive conserve plusieurs versions d'une page dans le temps, ce que l'ancien cache ne faisait pas. Trois façons d'y accéder :
- Collez l'URL dans le champ de recherche sur web.archive.org, puis choisissez une date dans le calendrier.
- Tapez directement web.archive.org/web/*/ suivi de l'URL complète pour voir toutes les captures.
- Depuis Google : cliquez sur les trois points à côté d'un résultat, puis « Plus d'infos sur cette page », puis le lien vers la Wayback Machine. Le lien n'apparaît pas pour les sites qui ont demandé leur retrait de l'archive.
Pour forcer une capture maintenant, utilisez la fonction Save Page Now. C'est le réflexe à avoir avant toute modification importante d'une page : vous aurez un « avant » daté. Limite : l'archive ne capture pas tout, et la fréquence dépend de la popularité du site. Une page publiée et corrigée le même jour n'y figure souvent pas.
2. archive.today, pour une capture à la demande
archive.today (aussi joignable sous archive.ph) prend une capture d'une URL quand vous la soumettez, et conserve la page sous forme de texte et de capture d'écran. Il sert à figer une preuve : un prix, une condition, une page concurrente, à une date donnée. Il ne remonte pas dans le temps comme la Wayback Machine, mais il archive souvent des pages que celle-ci refuse.
3. L'inspection d'URL de la Search Console, pour votre propre site
L'outil d'inspection d'URL répond à la vraie question derrière la plupart des recherches « cache Google » : qu'est-ce que Google a vu sur ma page ? Pour une URL indexée, « Afficher la page explorée » montre le HTML récupéré lors de la dernière exploration, les en-têtes HTTP et la date. Le « Test en direct » va plus loin : il récupère la page maintenant et affiche une capture d'écran du rendu tel que Google le voit, le HTML et les erreurs de console.
C'est plus précis que ne l'était le cache, parce que l'outil distingue ce qui a été exploré, ce qui a été indexé et ce qui est rendu. Deux limites : il faut être propriétaire vérifié du site, et le nombre d'inspections par jour est plafonné par propriété.
4. Bing Webmaster Tools, pour votre site aussi
Bing a retiré ses liens de cache en décembre 2024, mais Bing Webmaster Tools garde un outil d'inspection d'URL qui montre le contenu exploré par Bingbot. Utile pour comparer ce que les deux moteurs ont retenu d'une page, en particulier après une refonte.
5. Votre propre historique : CMS, sauvegardes, cache navigateur
Sur un site que vous gérez, la source la plus complète est interne. Webflow conserve des sauvegardes du site à restaurer, WordPress garde les révisions de chaque page, et un dépôt Git garde tout. Le cache de votre navigateur, lui, ne sert qu'à vous : il peut vous montrer une version récente d'une page que vous avez visitée, mais il n'a aucun rapport avec ce que Google a indexé.
Quelle méthode pour quel besoin
| Besoin | Méthode à utiliser | Limite |
|---|---|---|
| Voir une page supprimée ou un site disparu | Wayback Machine, puis archive.today | Rien si la page n'a jamais été capturée |
| Vérifier ce que Google a indexé sur ma page | Search Console, inspection d'URL, « Afficher la page explorée » | Site vérifié seulement, quota quotidien |
| Vérifier ce que Google a indexé sur un site tiers | Requête site:domaine.fr et lecture de l'extrait affiché | Aucun accès au HTML vu par Google |
| Retrouver un ancien contenu de mon propre site | Sauvegardes du CMS, Git, puis Wayback Machine | Les sauvegardes ont une durée de rétention |
| Comparer avant et après une refonte ou une migration | Capture Save Page Now avant la bascule, inspection d'URL après | À prévoir avant, pas après |
| Figer une preuve datée (prix, mention, page concurrente) | archive.today | Capture statique, pas d'historique |
Comment « vider le cache Google »
La requête revient souvent, et elle recouvre trois demandes différentes. Aucune ne passe par un bouton « vider le cache » : il n'en existe pas dans la Search Console.
Faire prendre en compte une modification. Dans la Search Console, inspectez l'URL et cliquez sur « Demander une indexation ». Google place la page dans sa file d'attente ; le délai va de quelques heures à quelques jours, sans garantie et avec un quota quotidien. Pour un lot de pages, mettez à jour la date de modification dans le sitemap plutôt que de soumettre les URL une par une.
Retirer une page des résultats. L'outil « Suppressions » de la Search Console masque une URL pendant environ six mois. C'est un sursis. Pour un retrait durable, agissez sur la page : balise noindex, protection par mot de passe, ou suppression accompagnée d'une redirection 301 vers la page qui la remplace. Le même outil propose d'effacer l'extrait affiché dans les résultats jusqu'à la prochaine indexation, ce qui est le plus proche d'un « vidage de cache » qui existe encore.
Corriger un résultat obsolète sur un site qui n'est pas le vôtre. L'outil « Supprimer un contenu obsolète » de Google traite ce cas, à condition que la page ait réellement changé ou disparu. Google compare le contenu actuel au résultat affiché avant d'accepter.
Vider le cache de votre navigateur est un autre sujet, souvent confondu. Il n'a aucun effet sur Google. Rechargez sans cache avec Ctrl + Maj + R (Windows, Linux) ou Commande + Maj + R (macOS), ou testez en navigation privée. Neuf fois sur dix, une modification « pas en ligne » est en ligne : c'est le cache local ou celui du CDN qui retarde.
Ce que ce retrait change pour le SEO
Trois conséquences pratiques, que nous constatons chez nos clients depuis 2024.
- L'accès à la Search Console est devenu indispensable. Sans propriété vérifiée, personne ne peut plus voir ce que Google a lu sur une page. Dans un projet de refonte, c'est le premier accès que nous demandons.
- Les outils « cache checker » sont morts. Ceux qui existaient avant 2024 interrogeaient le cache Google. Ils n'ont plus rien à interroger. Méfiez-vous de ceux qui prétendent encore afficher « la version en cache de Google ».
- La veille concurrentielle passe par les archives. Pour suivre les changements d'une page concurrente, programmez vos propres captures sur archive.today ou avec Save Page Now, plutôt que d'espérer une capture automatique.
Un audit technique SEO remplace avantageusement l'ancien réflexe du cache : exploration, indexation, rendu JavaScript, balises canoniques. Le cache ne montrait qu'une copie ; l'audit montre pourquoi Google l'a lue ainsi.
Comment nous vérifions ce que Google voit pendant une migration
Notre cas : en octobre 2026, nous avons migré notre propre site d'agence-synqro.fr vers synqro.co. Nous avons écrit et testé 485 redirections avant la bascule. Sans cache Google, la vérification s'est faite en quatre étapes, que nous appliquons à toute refonte de site chez nos clients :
- Avant la bascule, export de toutes les URL indexées depuis la Search Console et les rapports de performance, puis capture des pages stratégiques avec Save Page Now : un « avant » daté, consultable par tout le monde.
- Test de chaque redirection avec un script qui relève le code HTTP et l'URL finale, ligne par ligne, avant la mise en ligne du nouveau domaine.
- Après la bascule, inspection d'URL sur un échantillon d'anciennes et de nouvelles adresses : la page explorée doit montrer la redirection, puis la nouvelle page avec sa balise canonique.
- Suivi quotidien du rapport « Pages » de la Search Console des deux propriétés pendant les premières semaines, jusqu'à ce que les anciennes URL passent en « Page avec redirection ».
Ce que nous recommandons : ne cherchez pas de remplaçant au cache, changez de question. « Qu'est-ce que Google a vu ? » se vérifie dans la Search Console. « À quoi ressemblait la page ? » se vérifie dans les archives, à condition d'avoir capturé avant. Nous appliquons la même règle sur les sites que nous suivons en SEO, comme Qobra, dont le trafic organique a été multiplié par 16 en deux ans d'optimisation : chaque mise en ligne importante est inspectée dans la Search Console le jour même.
Pourquoi Google a arrêté, selon nous : le cache servait de preuve publique de ce que Google avait lu. Depuis que le rendu JavaScript et l'indexation mobile ont rendu cette copie peu fiable, Google préfère un outil privé et précis pour les propriétaires, et renvoie le reste à Internet Archive. C'est moins pratique pour la veille, plus fiable pour le diagnostic.
Une page refuse de bouger dans les résultats ? Notre agence SEO à Paris prend en charge ce type de vérification d'indexation au quotidien, en visio ou dans vos locaux. Envoyez-nous l'URL.
Questions fréquentes
Non. Le lien « En cache » a été retiré des résultats fin janvier 2024, confirmation de Danny Sullivan le 1er février 2024, et l'opérateur cache: a été désactivé le 24 septembre 2024, avec le retrait de sa documentation. Google renvoie désormais vers la Wayback Machine d'Internet Archive depuis le panneau « À propos de ce résultat ».